
总览与事件
先看总览
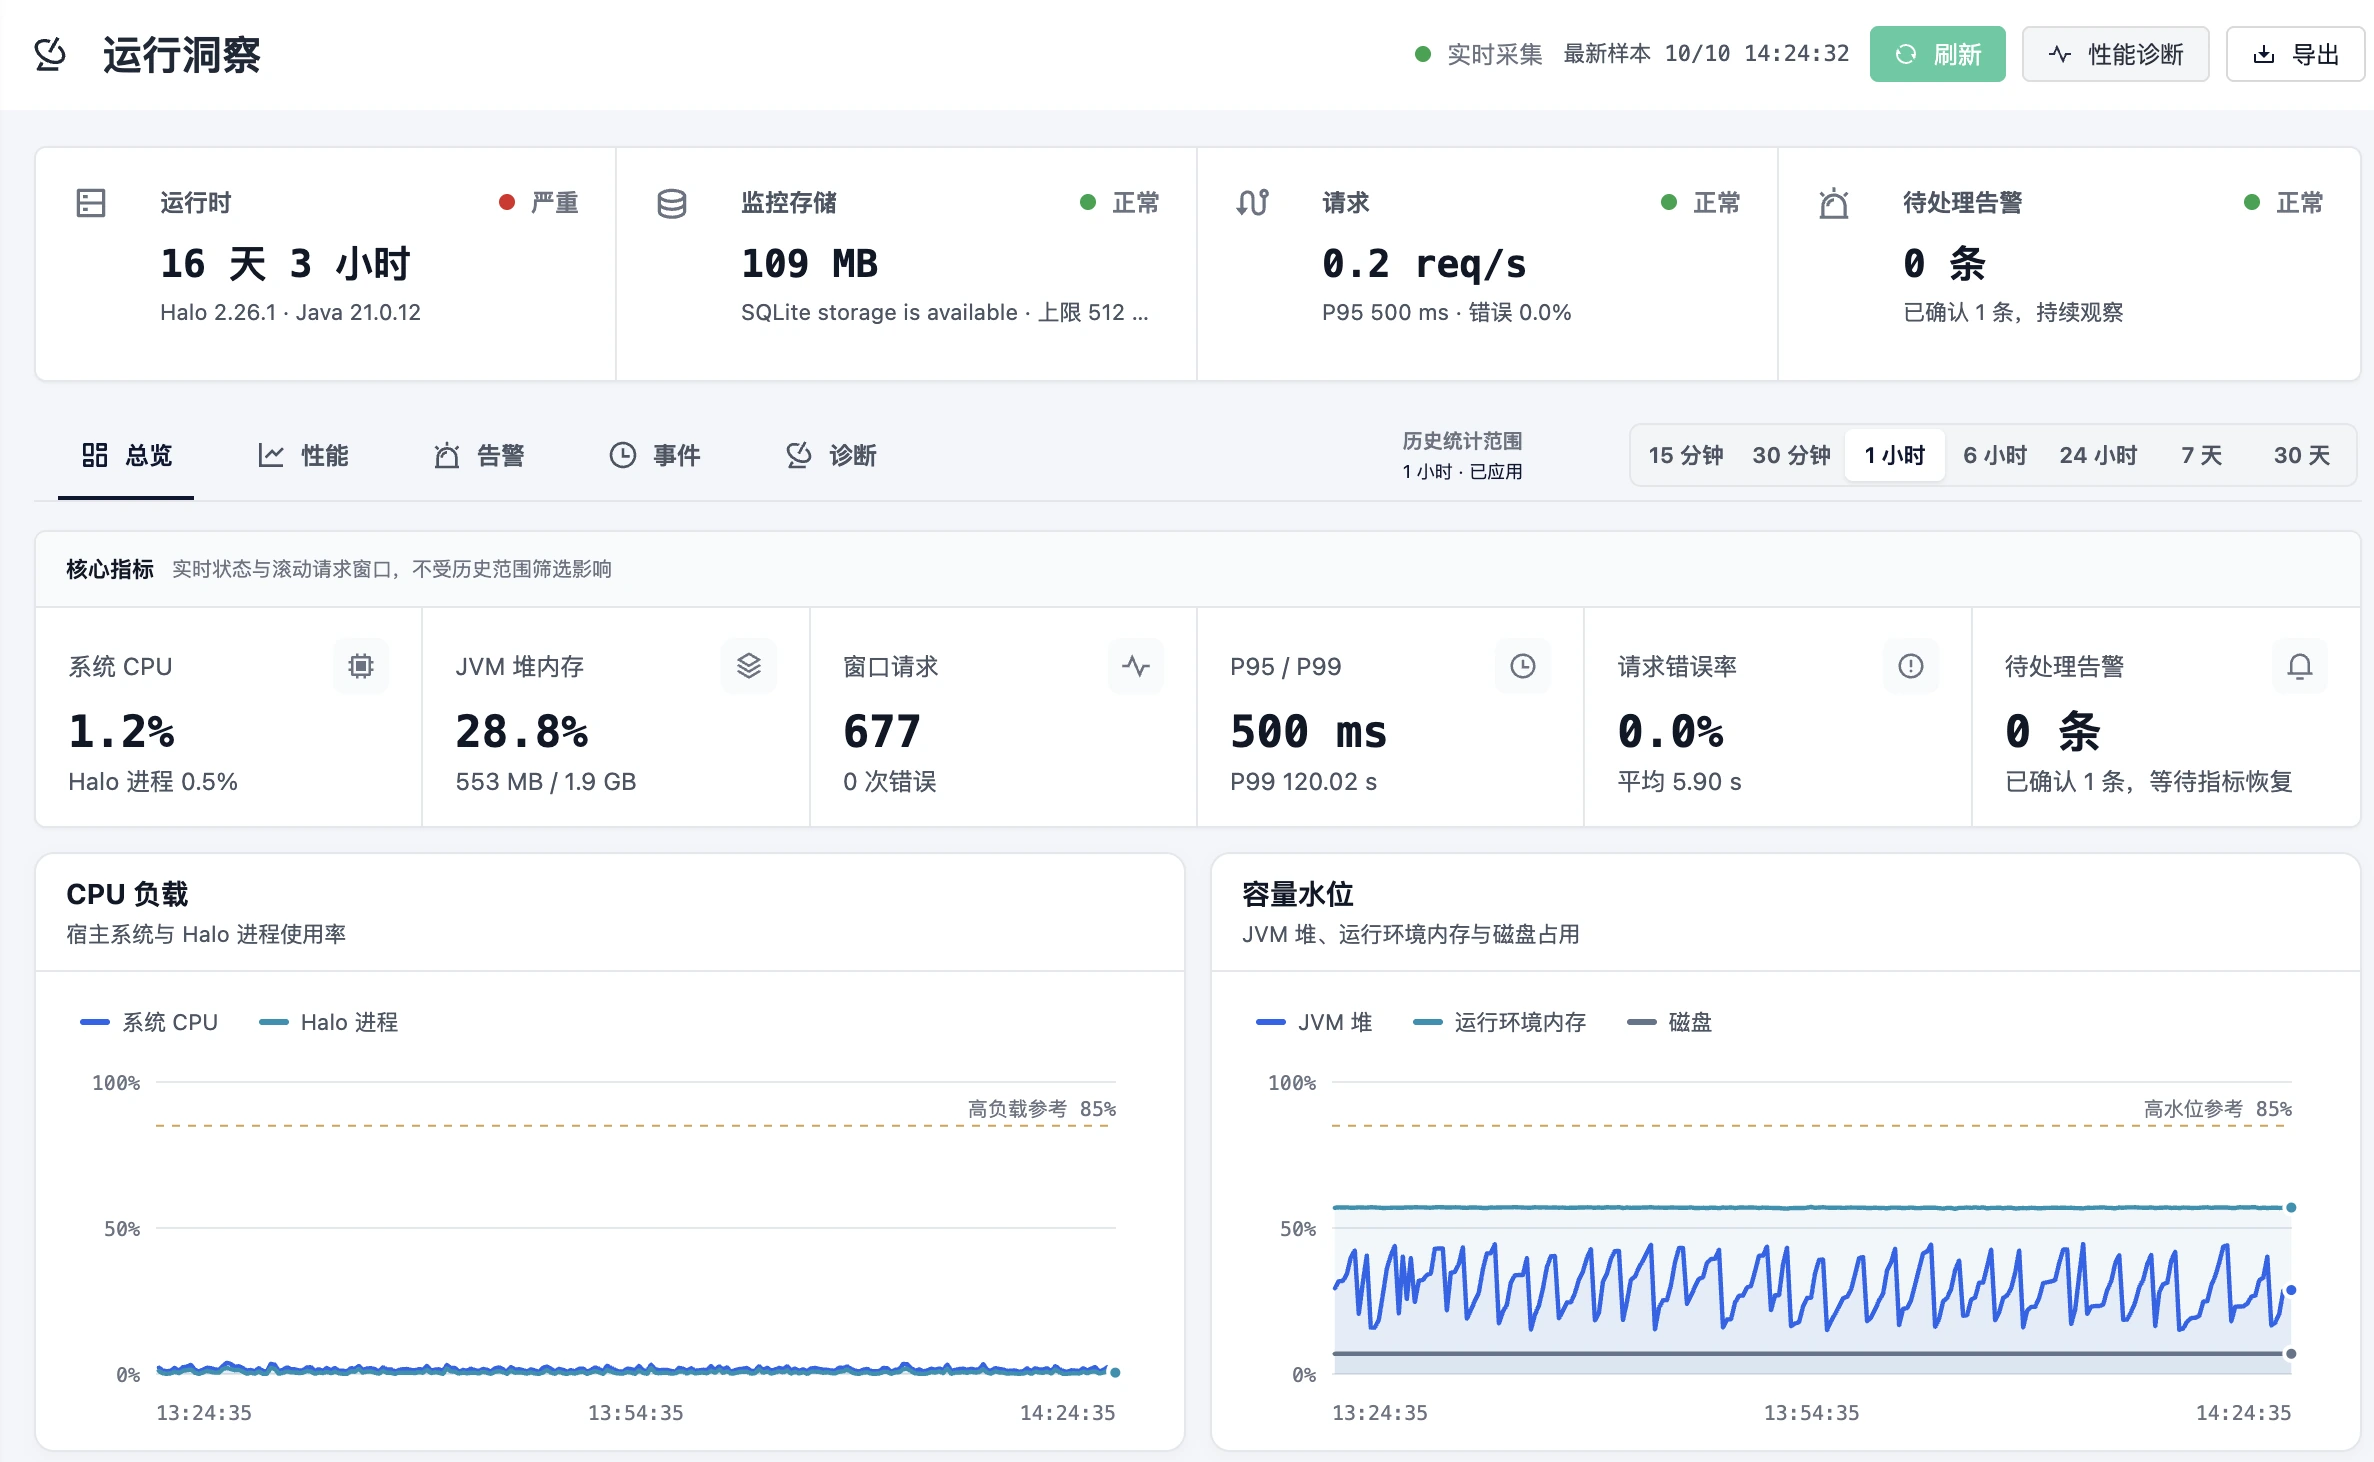
顶部状态栏汇总运行时、监控存储、请求和待处理告警。遇到红色或黄色状态时,先查看对应说明,再到性能、告警或诊断页继续排查。
确认告警只是表示已经知晓和处理,不等于故障恢复。因此可能出现「待处理告警为 0」但运行时仍标红的情况。
实时状态与历史范围
总览和性能页支持 15 分钟、30 分钟、1 小时、6 小时、24 小时、7 天和 30 天。切换范围后,先确认页面显示「已应用」,再读取趋势或排行。
顶部健康状态和「核心指标」反映实时状态及滚动请求窗口,不受历史范围筛选影响。下面的历史趋势、接口排行和插件分析使用选中的时间范围。告警、事件和诊断页有各自的筛选或查询方式,不能把全局时间范围理解为所有页面统一的过滤条件。
指标怎么读
Halo 依赖健康包括数据库查询、搜索和附件存储的只读探测,以及采集任务状态。某项不可用时,请先检查页面给出的原因和对应服务;未知状态不能直接理解为正常。
事件时间线
「事件」记录 Insight 启停、插件启停和版本变化、配置变化、异常、告警恢复等运行事件。定位问题时,把事件时间与资源趋势、慢接口及告警触发时间对齐。
例如,升级插件后出现高延迟,可以先找版本变化事件,再从性能页打开该插件,查看升级前后的基线。没有记录到的版本变化不会自动补造事件。
导出和清理
拥有管理权限时,可从页头导出监控 JSON,或使用数据清理入口释放历史存储。普通 JSON 导出排除 JFR 调用栈和通知载荷,原始 JFR 需从诊断页单独下载。
导出适合保存一段排查所需的结构化证据。清理会影响历史排行、事件和基线对比,请在确认不再需要这些历史后操作。